真实项目案例
专利知识产权大模型应用
通过专利文档解析、向量检索、RAG、提示工程与模型服务构建可追溯的知识检索和问答应用。
- 知识产权AI
- RAG
- 向量检索
- 大模型应用
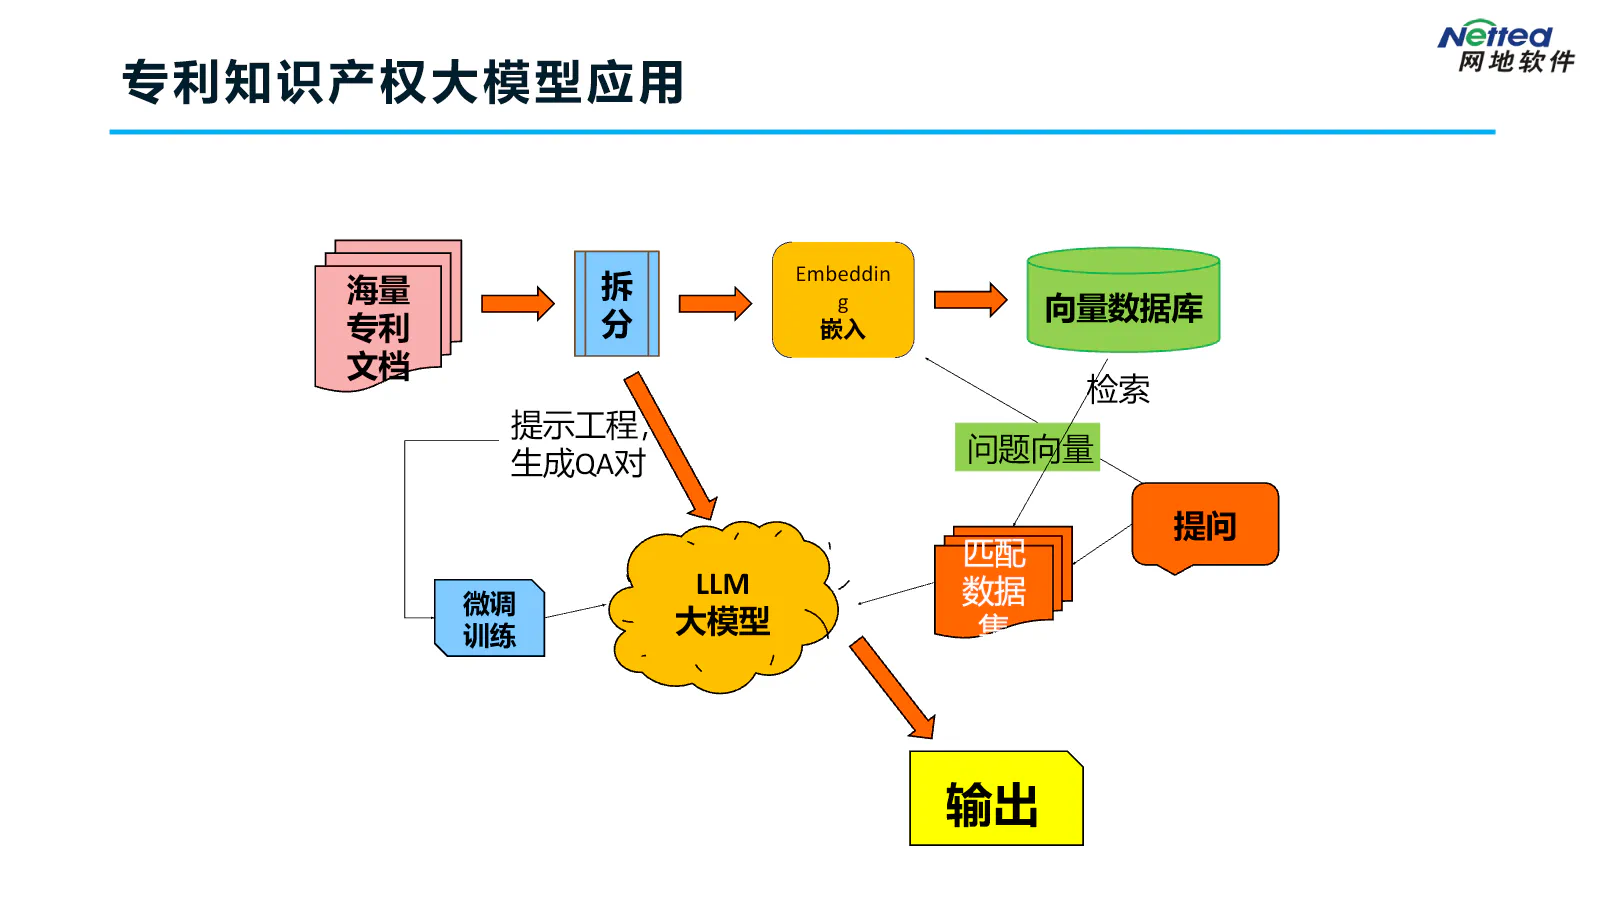
直接答案: 专利知识产权大模型应用将海量专利文档解析为可检索知识,通过Embedding和向量数据库找到与问题相关的材料,再由大模型结合检索结果生成回答;必要时还可用提示工程构造问答数据并进行针对性微调。
技术链路
专利文档 → 文档解析与拆分 → Embedding向量化 → 向量数据库 → 问题向量与检索匹配 → 大模型生成 → 来源与结果输出。
系统也支持“提示工程生成问答对—整理训练数据—模型微调”的可选路径。是否微调,应根据任务准确性、专有术语、样本规模、维护成本和基础模型能力评估,而不是默认采用。
系统能力
- 专利PDF或结构化数据导入、解析与分段
- 标题、申请人、分类号等元数据管理
- 语义检索、关键词检索和条件过滤
- 基于检索增强的知识问答与摘要
- 回答来源、引用段落和检索证据展示
- 用户权限、模型配置、日志与评估集管理
质量与安全
专利语义复杂、文本长且存在法律与技术解释边界。系统应保存来源、版本和检索证据,对无法找到充分依据的问题拒答或提示补充条件。涉及法律状态、侵权或有效性判断时,AI输出只能作为信息整理和辅助分析,仍需专业人员核验。
可扩展方向
在专利知识库基础上,可进一步连接企业研发文档、技术术语库和项目数据,支持技术检索、相似方案查找、问答辅助和研发知识管理。具体功能需围绕使用者任务与可验证的评估集逐步建设。
案例常见问题
专利知识AI是否等于训练一个新大模型?
不等于。系统以文档拆分、Embedding、向量检索和大模型生成为主,并可根据任务需要增加提示工程、问答数据构造或微调。
如何降低知识问答的错误风险?
需要保留专利来源和段落引用,设置权限与检索过滤,使用固定评估问题,并对专业结论保留人工复核。