什么是企业AI系统
企业AI系统将大模型、专用模型或规则能力与企业自己的文档、数据、权限和流程连接起来,帮助员工检索信息、整理材料、辅助判断或完成受控任务。它需要对“答案来自哪里、谁能访问、结果如何评估、错误由谁复核”负责,而不只是调用一个通用模型接口。
适合解决哪些问题
- 分散在制度、产品、项目和技术文档中的知识难以查询
- 客服、售前或内部支持需要从可靠资料中快速组织答复
- 合同、报告、工单和表格存在大量重复阅读与信息提取工作
- 业务人员需要用自然语言查询经过授权的数据
- 已有系统流程希望增加分类、摘要、检索或内容辅助能力
规则明确、数据规模小且传统搜索已经足够的问题,不应为了“使用AI”而增加模型复杂度。涉及高风险决策时,系统输出应保留人工复核和明确责任边界。
总体技术架构
企业文档与业务数据 → 解析、清洗和元数据 → 权限映射 → 向量与关键词检索 → 模型与工具调用 → 引用、规则和结果校验 → Web或现有业务系统 → 日志、反馈与评估。
数据源可以包括文件、知识库、数据库和业务接口。模型层可组合通用大模型、专用模型、规则和工具,不把所有任务都交给单一模型完成。
知识治理与检索增强
上线前需要确认文档所有者、版本、有效期、密级和适用范围。分段策略应保留标题、章节和来源关系;检索同时考虑语义、关键词、过滤条件和权限。回答页面应展示可核对的来源,并对没有充分依据的问题拒答或提示补充信息。
模型、工具与业务流程
知识问答侧重检索与引用;文档处理侧重结构化提取和校验;流程自动化还需要调用企业系统的查询或操作接口。对写入、审批、发送等动作,应增加权限、参数确认、幂等、审计和失败处理,避免模型直接执行不可恢复操作。
LLM、SLM、RAG与Agent如何分工
- LLM:承担通用语言理解、生成、摘要和复杂推理
- SLM:在算力、成本、时延或专用任务受限时承担轻量模型能力
- RAG:先从企业文档与数据中检索证据,再由模型结合来源回答
- Agent:在明确权限和规则下调用检索、查询或业务工具,完成多步骤任务
实际系统可组合这些能力。知识问答通常先验证RAG;固定分类、抽取或端侧任务可评估小模型;只有需要跨系统连续操作时,才引入Agent和严格的执行保护。
自然语言查询数据:Text-to-SQL
Text-to-SQL让用户用自然语言提出数据问题,由系统识别相关数据表、字段与口径,生成受控查询并返回结果。它不能直接对全部生产数据库开放,应增加只读账号、数据字典、允许查询范围、SQL校验、执行超时、结果脱敏和审计日志。
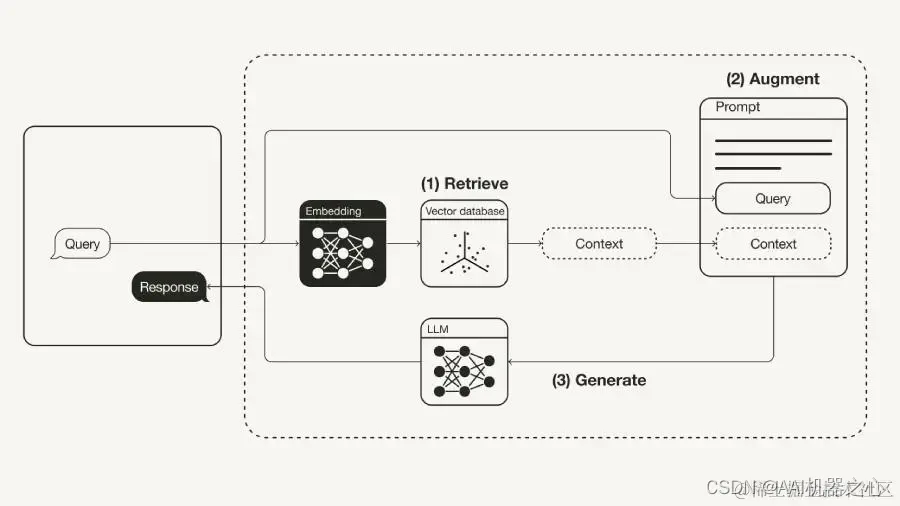
专利知识产权大模型应用 采用文档拆分、Embedding、向量数据库、检索匹配和大模型生成,并可按任务需要增加问答数据构造与微调,是企业知识AI落地的一类具体实践。
软件平台与系统集成
可通过独立Web应用、企业门户插件或API接入现有系统。平台负责用户与组织、知识空间、会话与任务、反馈、模型配置、用量、审计日志和评估数据。与CRM、ERP、工单或文档系统连接时,需要明确数据字段、接口频率和异常降级方式。
安全与权限
访问控制应贯穿数据检索、模型上下文、工具调用和结果展示。系统需要避免不同组织或角色之间的数据串读,敏感字段可在进入模型前脱敏。部署方式还需结合模型服务的数据政策、日志保存和企业运维能力评估。
验收指标
| 维度 | 建议检查 |
|---|---|
| 检索 | 相关资料是否被找到、权限过滤是否正确 |
| 回答 | 事实一致性、来源覆盖、拒答和人工复核比例 |
| 流程 | 参数正确率、执行成功率、异常与回滚能力 |
| 体验 | 响应时间、可理解性、用户任务完成率 |
| 运维 | 日志、版本、成本、模型或知识更新效率 |
实施流程
场景优先级与风险梳理 → 数据和权限审查 → 小型评估集 → 检索与模型PoC → 业务界面和接口MVP → 权限、安全与审计 → 小范围试用 → 评估、反馈和迭代。
主要交付内容
交付范围可包含知识与数据接入规范、检索与模型服务、业务接口、用户平台、权限与审计、评估集与测试记录、部署说明和运维方案。若企业仍在判断首个AI场景,可先从AI定制开发 或项目可行性评估 开始。
常见问题
企业AI是否必须训练自己的大模型?
通常不必先训练大模型。可先比较提示工程、知识检索、工具调用、工作流和小规模微调,选择满足准确性、成本与数据边界的最小方案。
RAG知识库能保证回答完全正确吗?
不能作绝对保证。需要通过来源引用、权限过滤、拒答策略、固定评估集和人工复核降低错误风险,并明确可自动执行与仅供参考的边界。
企业AI可以私有化部署吗?
可以根据数据敏感性、模型规模、并发、算力和运维能力评估本地、专有云或混合部署,具体路线需经过成本与性能测试。